Project case study
CitedRAG · 引证式技术文档问答系统
面向技术文档的证据优先 RAG:导入论文与文档后提问,返回带来源与页码引用的回答;证据不足时明确拒答,而不是猜测。
一句话概括:把论文与技术文档变成可追问、可核验的本地知识库——每个结论都带来源与页码,证据不足时明确拒答,而不是猜测。
CitedRAG 是一个本地优先(local-first)、单用户的技术文档问答系统:导入论文与文档,用自然语言提问,得到带来源与页码引用的回答;当检索证据不足或引用无法被验证时,系统返回固定的拒答文案,而不是生成一个「看起来合理」的答案。本页给出项目概况、总体架构、一次提问的端到端流程与评测结果,逐模块的实现细节见页面底部的系列文章列表。
一、项目概况
技术文档问答的难点不是「能不能检索到」,而是回答是否可以被核验。通用聊天模型可以流畅地总结一篇论文,但一旦需要回到原文核对,读者必须自己重新定位到具体页码;而把带引用的回答直接交给读者时,引用与结论是否真的对应,通常无人检查。CitedRAG 围绕三个核心问题设计:
- 可验证引用。回答中的每个关键结论都必须带
[N]角标,角标映射到本次检索到的证据;系统逐句校验「结论—证据」的蕴含关系,校验不通过或校验服务不可用时失败关闭(fail-closed),而不是返回未经核实的文本。 - 页码级定位。回答片段与引用卡片携带来源文档与页码,前端可以跳转到文档详情页对应的上下文;索引在切分阶段就维护
source / page / chunk_in_page契约(backend/src/rag/loader.py:9),不依赖生成后再反查 PDF。 - 证据不足拒答。检索无结果、引用编号越界、引用与结论不匹配时,统一返回固定文案「提供的文档证据不足以回答该问题」(
backend/src/rag/generator.py:48),并附结构化 warning 说明缺口与下一步建议。
对应的设计原则贯穿全栈:证据优先(先检索再回答)、fail-closed(无法验证就不回答)、本地优先(除 LLM 与模型下载外不依赖外部服务)、按需升级(简单问题走一次检索直答,复杂问题才付多 Agent 成本)。明确非目标:不做多用户与权限体系、不做分布式部署、不追求通用 Agent 能力;这些取舍在 CONTRIBUTING.md 的 Scope 一节中写得很清楚。
二、总体架构
flowchart TD
    U["React 19 前端<br/>聊天 / 文档 / 评测 / 诊断"] -->|"REST + SSE /api/v1"| API["FastAPI API 层"]
    API --> SVC["services 层<br/>documents / runs / workspaces / arxiv"]
    SVC --> G["LangGraph 编排<br/>supervisor 动态路由"]
    G --> D["direct<br/>简单问题直答"]
    G --> P["planner<br/>拆解为最多 3 个任务"]
    P -->|"任务列表"| R["researcher<br/>并行检索任务"]
    G --> W["writer<br/>汇总成稿"]
    D --> RET["检索流水线<br/>dense + BM25 → RRF → 重排 → 父扩展 → CRAG"]
    R --> RET
    RET --> GEN["生成 + 引用 / 蕴含校验"]
    W --> GEN
    GEN -->|"引用成立"| OUT["带来源与页码引用的回答"]
    GEN -->|"证据不足 / 校验失败"| REF["固定拒答"]
    G -.->|"高成本计划暂停"| HITL["人工审批 interrupt"]
    G -.->|"thread_id"| CKPT[("SQLite Checkpointer")]
    SVC --> DB[("SQLite<br/>runs / documents / sessions")]
    SVC --> IDX[("分段 FAISS 索引<br/>manifest / 快照 / FTS5")]
三、一次提问的完整旅程
以 POST /api/v1/workspaces/{id}/ask/stream 为例,从请求到带引用的回答(下图为最终效果):
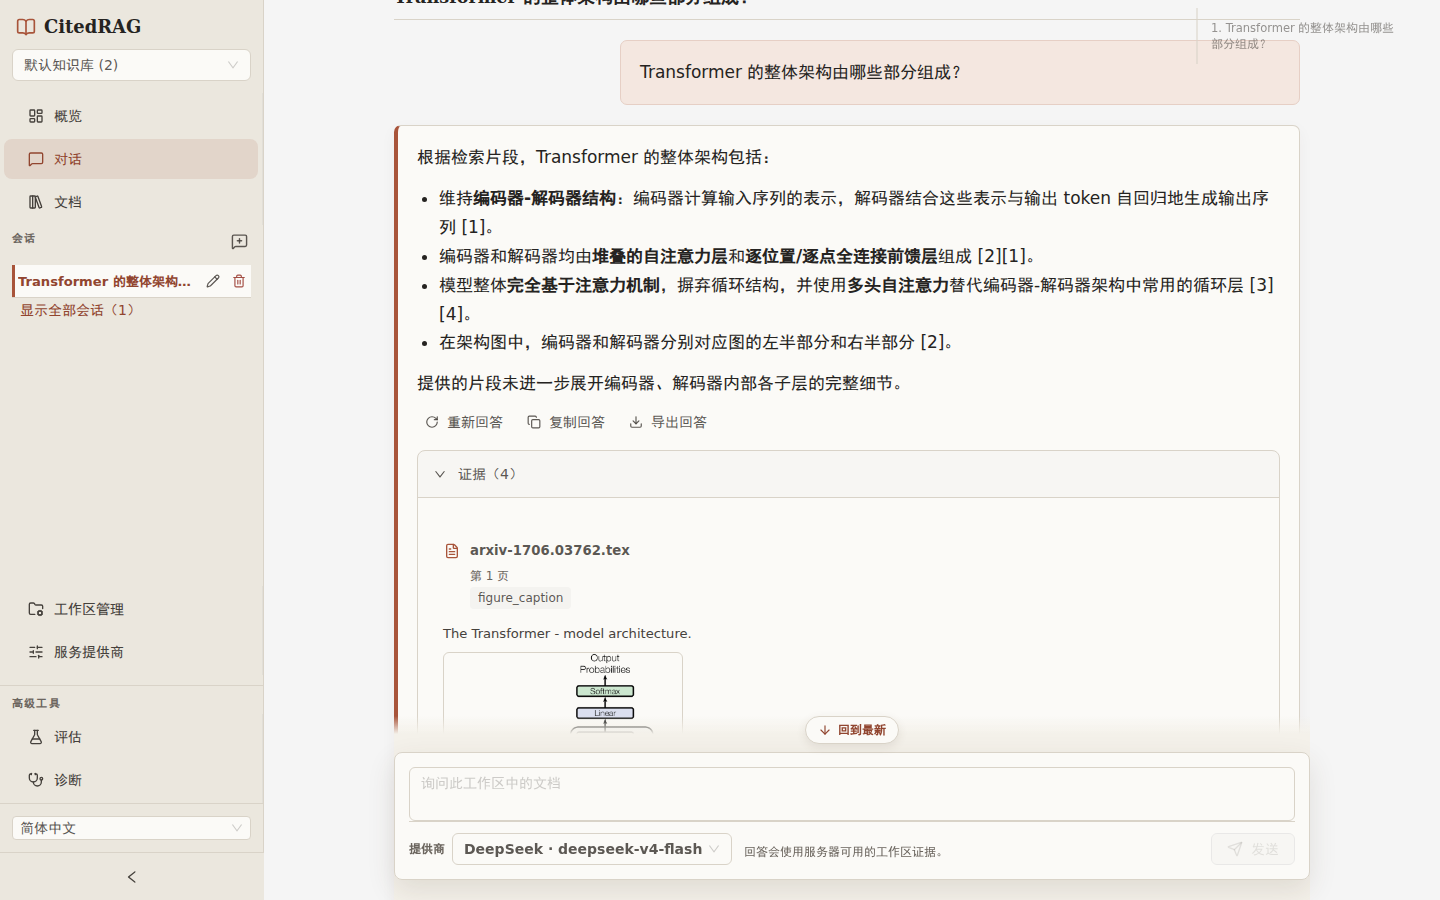
整个过程串起幂等抢占、后台图执行、SSE 交付与异常恢复四类机制,下面按执行顺序拆开。
- 路由与校验(
api/routes/runs.py:38):校验工作区存在 → 解析/校验会话(无 session 时以问题前 50 字新建标题,会话必须属于该工作区)→ 按provider_profile_id解析本次请求的 LLM 配置。 - 幂等抢占(
services/runs.py:49):用client_request_id+ 请求指纹抢占 run 行;重复请求按状态返回已完成结果或 409;抢占成功后创建取消事件。 - 开流:
StreamingResponse包装sse.v1_events;首个事件是run_started(携带 run_id / session_id / request_id)。 - 后台执行(
sse.run_events:28→answer_and_persist:84):构建历史消息(≤8000 字符)→ 启动看门狗 → 调graph.answer(thread_id=run_id, callbacks=...)。 - 图执行(
agent/graph.py:102):- supervisor 首轮命中启发式直答 →
direct; direct调retrieve_dispatch:dense 检索 + FTS5/BM25 各自排名 → RRF 融合(叠加章节权重)→ 取 30 条候选做 CrossEncoder 重排(sigmoid 校准 + 0.40 阈值 + MMR)→ 父文档扩展(≤1200 字符)→ 去重 / lost-in-middle 重排 → 返回 8 条证据;证据一到就通过evidence_callback推给前端(evidence事件,来源卡片先渲染);direct流式生成:每个 token 先进入_ValidatedStreamer,按句批次做引用与蕴含校验,通过的句子带增量重编号实时推送(answer_delta事件);工具与决策 trace 实时推送(trace事件);- 若 direct 拒答:supervisor 暂存该回答并升级到 planner → 拆出 ≤3 个任务 → 命中审批阈值则 interrupt(
approval_required事件,流结束,状态awaiting_approval;批准后POST /runs/{id}/approval从 checkpoint 继续); - researcher 并行执行任务(retrieve 模式下不调用 LLM),证据按 id 合并回 state;writer 对证据再排序并套预算后成稿,同样走引用强制与逐句校验。
- supervisor 首轮命中启发式直答 →
- 持久化:
persist_completed_run在一个BEGIN IMMEDIATE事务里写 user/assistant 消息、trace,并更新 run 行为completed、committed=1(要求 run 仍为 running 且工作区代际一致,否则抛RunNotActiveError,SSE 转为取消)。 - 收尾:SSE 依次发
metadata(citations / trace / delegation_path / warnings / errors / research_tasks)与done(终态与完整答案);前端useChatRun更新为 complete 并刷新会话/消息查询。 - 异常路径:客户端断线 → 服务端置取消事件停止生成;用户点停止 →
POST /runs/{id}/cancel置事件 + 前端中止 fetch;进程重启 → run 标为 interrupted,前端按 run_id / client_request_id 恢复,或经 resume 端点从 checkpoint 续跑。
四、评测结果与复盘
- 检索评测(gold50,默认 hybrid + rerank + parent expansion,top_k=8):可答题 41/45,来源命中 100%(45/45),页码命中 93%;dense 模式 44/50(含 5 道拒答题全部判为合理拒答)。注意 41/45 与 44/50 的分母不同——前者是「可答题通过率」,拒答题在 sigmoid / RRF 尺度不判分;后者是 dense 模式下「可答题 + 拒答题」的合计通过数,两数直接比较没有意义。
- 编排评测(15 个任务):默认路径 15/15 有据(grounded)、14/15 成功;planner 任务在不逐轮调用 LLM 的 retrieve 模式下 6/6 通过;平均检索调用数约为 ReAct 模式的 1/6。
评测集的构造方式、指标口径与完整结果见 LLM 应用的评测与测试;检索评测的复跑方式见 评测复跑;CI、提交规范与依赖管理见 LLM 应用的交付形态与工程化;WSL2 显存防护、主动取舍与已知问题见 两个项目教会我们的事。
复盘。 这个项目最大的收获来自「把指标当设计约束」:混合检索的每一项(chunk 800、top_k 8、MMR λ=0.88、关闭 rewrite)都不是凭感觉选的,而是 gold50 矩阵跑出来的;反过来,引用校验与拒答链路的每一项都选择了保守的 fail-closed,因为「不回答」比「回答了但无法核验」对文档问答的伤害更小。工程上,最耗时的不是算法,而是状态一致性:文档入库与索引发布的事务性、运行与工作区的代际栅栏、SSE 断线后的恢复、checkpoint 与凭证的隔离——这些「看不见的部分」决定了系统在真实环境下是否可信。
路线图(基于仓库中已有的升级位与默认关闭项):
- 把 basedpyright 纳入 CI,让类型检查成为门禁;
- 在更大语料上重跑矩阵,评估 multi-query / CRAG / 压缩的净收益,再决定是否改变默认值;
- 按
storage/backend.py的协议实现 postgres/pgvector 后端,为多用户与并发写留出空间(当前已预留配置位storage.backend); - 扩充 gold 集与编排任务集(尤其多文档比较与中文提问),并让评测报告入库或由 CI 定期产出,使LLM 应用的评测与测试中的数字可独立复算;
- 补充图注/公式类证据在前端的呈现与评测(当前
content_type与 asset 链路已通,但 gold 集未按内容类型标注)。
Articles
相关文章
Agent 是怎么跑起来的
从 ReAct 循环到异步事件流,拆解 Agent 运行内核、流式工具执行与多协议模型客户端的归一化。
用 LangGraph 组织 RAG 工作流
从 CitedRAG 的五节点图出发,讲清状态、预算、中断恢复,以及多 Agent 框架的选型逻辑。
混合检索与 RAG 工程
从 CitedRAG 的真实流水线讲清切分、dense 与 BM25、RRF、重排、父扩展与向量库选型。
让 RAG 的回答可信
介绍 CitedRAG 如何用引用校验、fail-closed 拒答与评测,把回答可信落实为可执行的设计约束。
LLM 应用的评测与测试
从 gold50 检索评测到全 mock 测试,讲清 LLM 应用如何定义口径、构造评测集,并把指标变成设计约束。