Article / 评测与交付
LLM 应用的交付形态与工程化
同一个 Agent 内核如何交付到终端、脚本与浏览器,以及事件流契约、流式协议、配置与部署背后的工程取舍。
同一个 Agent 内核,可以跑在终端里,也可以变成脚本里的一行命令,或者一个浏览器页面。模型决定能力上限,但用户是否信任它、是否愿意长期用它,往往取决于交付形态和那些看不见的工程细节——事件流怎么定义、流式协议怎么选、密钥放在哪里、部署要几步。这些问题在两个项目里都有具体答案,案例来自 NovaCode 与 CitedRAG。
三种交付形态共用一份事件流
NovaCode 的核心是一个异步生成器,把模型输出、思考过程、工具调用、用量、错误统一成事件流。TUI(在终端里运行的交互界面)、Print、Remote 三种前端是这份事件流的不同消费者:Textual 终端界面负责流式文本、可折叠的工具块和内联权限确认;-p 非交互模式把事件映射成 NDJSON(每行一个 JSON 对象)直接写向标准输出;--remote 在浏览器里渲染同一条时间线。差异集中在「事件怎么渲染、权限怎么裁决、进程怎么收尾」,Agent 主循环完全不需要知道自己跑在哪种前端下。TUI 是默认形态,职责也最重:流式文本实时刷新,工具调用折叠成可展开的块,权限请求挂成内联确认框,shift+tab 循环权限模式、esc 取消当前任务。三种前端共享的不只是事件类型,还有命令注册表和权限判定入口,一次内核改进会同时让三处受益;反过来,事件契约必须覆盖所有渲染者的需求,这也是事件契约要先定稿的原因。
uv run novacode -p "修复失败测试" --output-format text        # 只输出最终文本
uv run novacode -p "跑一次审查" --output-format stream-json  # NDJSON 事件流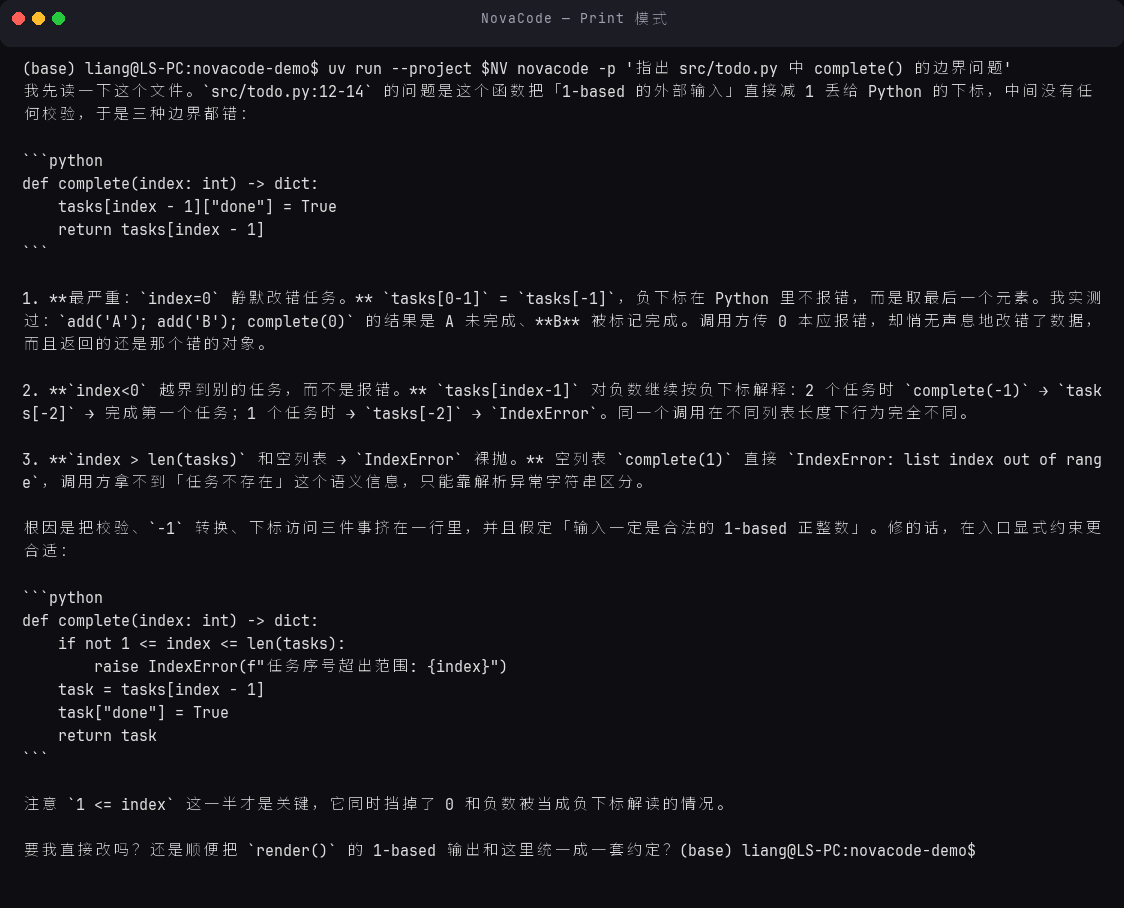
Print 形态的意义在于把 Agent 变成管道里的一环:assistant、tool_use、usage、result 这些事件可以直接被脚本消费,失败重试、结果归档都能用现成的 CI 机制处理。代价也要写清楚——非交互环境弹不出确认框,权限请求只能一律放行,而且这条路径没有挂 OS 沙箱(操作系统级隔离),安全姿态和 TUI 并不一致。这是有意的取舍,也正因如此,「每个入口的信任姿态要显式定义」被列进了修补计划(见权限与沙箱)。
Remote 形态选择 WebSocket(浏览器与服务器之间的双向长连接),因为浏览器端不仅要看,还要能回话:权限确认、取消任务这些操作需要一条反向通道,WebSocket 的全双工长连接正好满足。服务器同时提供静态页面与 WebSocket 端点,事件广播给所有连接,权限请求则以 pending 队列等待客户端回包。
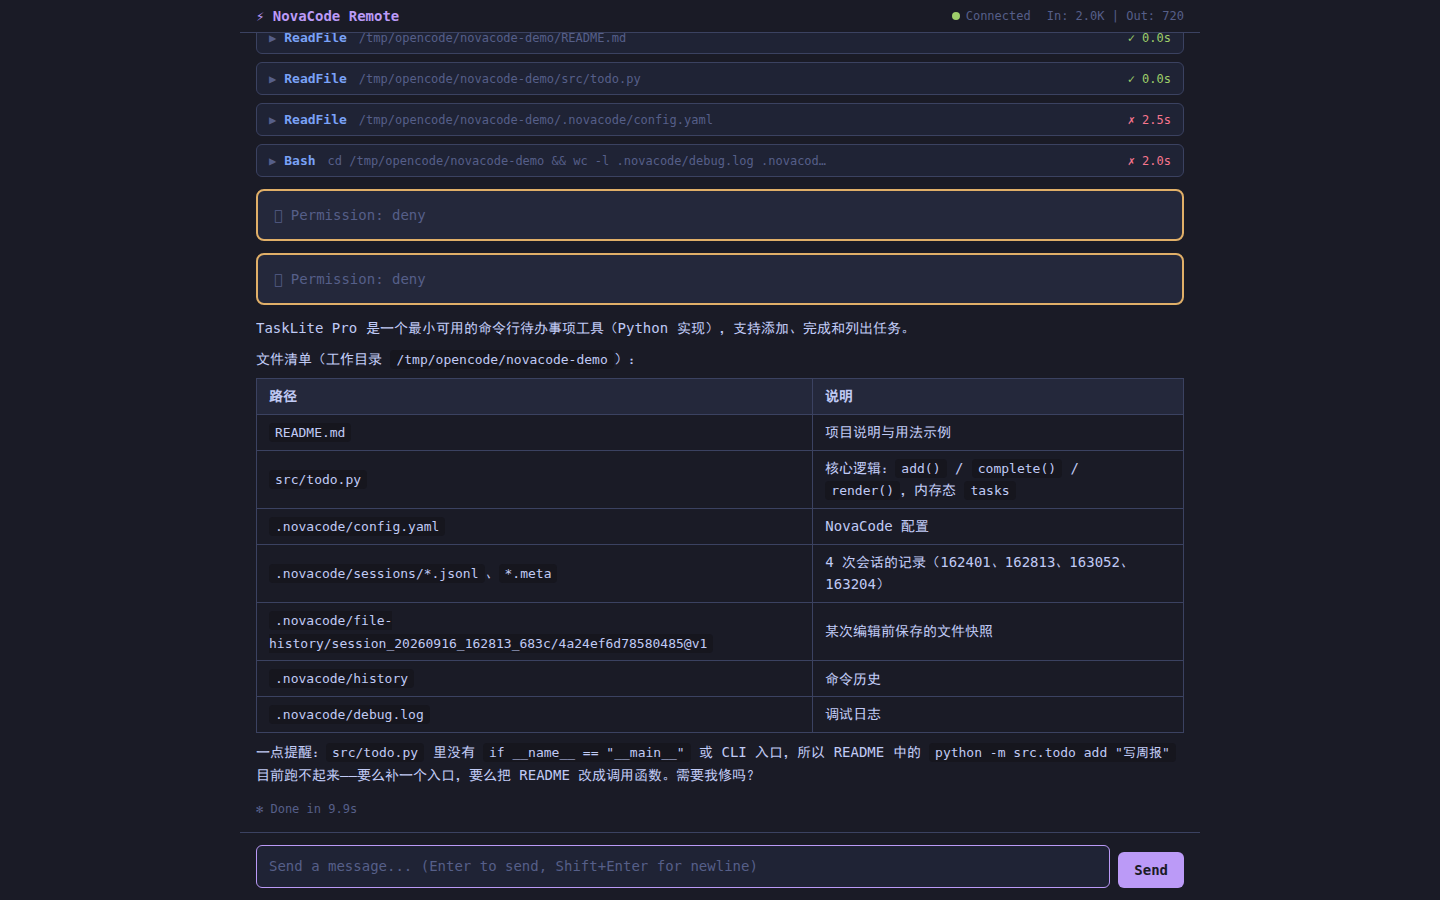
这条路径同样复用了同一套命令注册表,所以斜杠命令在浏览器里也可用;但取消语义和 TUI 是两套实现,取消主任务并不会打断已经提交的工具调用,这类「同一语义多份实现」的问题,会在复盘里展开。
SSE 与 WebSocket 的取舍
CitedRAG 的流式问答走了另一条路:POST 请求返回 SSE(Server-Sent Events,服务器通过普通 HTTP 连接持续向下游写文本事件),事件有固定协议——run_started 开场,evidence 先送证据卡片,answer_delta 带单调递增的 seq,收尾是 metadata 与 done;15 秒没有事件就发一行注释当心跳;错误也走 SSE 事件,不直接断开连接。
选择 SSE 的理由很直接:问答是单向推送,提问用 POST 携带问题体最自然,取消和审批本来就有独立的 POST 端点;同时 SSE 建立在普通 HTTP 上,对代理和负载均衡更友好——Nginx 侧只需要关掉缓冲(proxy_buffering off)并拉长读取超时,事件就能实时到达浏览器。如果客户端还需要在上行方向持续发送消息(比如 NovaCode 的权限回复与取消),WebSocket 更合适。协议选型先看一个问题:这条通道需不需要双向,哪个更新、哪个更流行都是次要的。审批场景能看出这套协议的边界:需要人工确认的运行以 approval_required 事件收尾并结束当前流,批准后由另一个 POST 端点从检查点续跑,不需要一个长连接悬停等用户点击——连接不承载业务状态,状态在数据库里。
前端消费这份协议的方式尤其严格:首个事件必须是 run_started,answer_delta 的序号必须从 1 连续递增,metadata 只能出现一次且必须在 done 之前,终态事件之后不允许再有事件。违反协议按 StreamProtocolError 处理,流的开始缺失或提前结束按断线处理,两种错误分开上报,保证「网络问题」不会被误判成「模型输出异常」。断线后前端用发起请求时存下的 client_request_id 反查运行状态,带着 recovering 状态轮询到终态,用户不会因为一次网络抖动丢掉整次运行。
更关键的一层在服务端:生成的 token 不会立刻流出,先按句批次做引用与蕴含校验,只有通过的句子才带增量编号推给前端。流式看到的答案和最终落库的答案完全一致,校验失败就立即停止输出、整题按拒答落库。很多产品把流式当作「先给用户看,后面再纠错」的乐观 UI;要交付可信结论,更稳妥的做法是让校验发生在推送之前。
归一化模型协议差异
模型供应商的差异会长期存在:NovaCode 同时支持 Anthropic、OpenAI 与一批 OpenAI-compatible 端点(vLLM、Ollama、Together 等),如果让主循环去认识每一种流式事件,代码很快会被协议细节塞满。它的做法是让每个客户端把各自的原始事件归一化成同一组 StreamEvent:文本增量、思考增量、工具调用开始、增量与完成、流结束。新增一种协议,只需要实现一个子类并在工厂函数里注册,主循环一行不改。
归一化里最容易被忽略的是用量口径。Anthropic 的缓存读取和缓存写入单独计数,OpenAI 系列只暴露缓存命中,而且 input_tokens 已经包含它——客户端必须把 input + cache_read 调整成可加的口径,上层统计才不会错账。
@dataclass
class StreamEnd:
    stop_reason: str
    input_tokens: int = 0
    output_tokens: int = 0
    cache_read: int = 0        # 缓存命中(Anthropic 按 10% 计费)
    cache_creation: int = 0    # 缓存写入;OpenAI 系列没有这一计数
prompt caching(把稳定的提示前缀缓存起来,后续请求命中缓存的部分只按很低的比例计费)在 NovaCode 里属于架构约束:系统提示、工具定义、最后一条用户消息尾部三个位置被打上缓存断点,工具结果在进入历史前就已定型,确保后续请求的前缀字节不变。MCP 工具的加载策略、工具搜索的暴露开关,都在服务这同一条约束——成本模型需要在架构层解决,不能等账单来了再优化。窗口解析也走归一化思路:显式配置优先,其次是启动时向兼容端点查询,再次是内置的模型名映射表,最后落到保守默认值(Claude 系 20 万、其余 12.8 万)。四层回退让未配置的新模型也能跑,同时避免把请求直接撞上窗口上限。
CitedRAG 面对的则是另一类 provider 差异:连接配置以 Profile 形式保存,凭证支持临时、环境变量、系统 keyring(操作系统的凭据管理器)、本地数据库四种模式,连接前先探测兼容端点;自定义 base_url 还要过 SSRF 防护(防止服务器被诱导去访问内部网络地址)——默认拒绝回环、私网、链路本地地址,只有显式放进白名单的主机才放行,用于本机 Ollama 这类场景。请求级的临时 LLM 配置只存在于内存与运行记录中,绝不写入检查点或数据库。供应商差异在边缘吸收,核心只认一套词汇,这是两个项目各自独立做出的相同选择。
配置分层与密钥边界
配置解决的是「哪个值最终生效」,这在多层来源并存时并不平凡。NovaCode 按用户级、项目级、本机私有级三层合并,但合并规则是逐字段定制的:providers 整段覆盖,mcp_servers 按名字替换或追加,hooks 追加,而 enable_fork 这类默认为真的开关必须支持显式关闭——简单深合并会让 false 被当成「没写」,功能就关不掉。字符串里的 ${ENV} 在加载时展开;API key 缺省时按协议回退到对应环境变量;MCP 子进程的环境变量单独构造,只继承 PATH 和显式声明的变量,不让服务器进程意外继承宿主的全部环境。
CitedRAG 的优先级链更细:代码缺省值 < settings.yaml < API 写入的覆盖层 < 任务级临时覆盖,最后一层让评测矩阵能在真实管线上改参数而不落盘。配置接口不仅返回生效值,还标注代码缺省值、作用域,以及「改动是否需要重启或重建索引」;用户级键可写,路径、模型、切块这些危险键只读;写入用临时文件加原子替换;任何含 api_key / secret / token / password 的键在响应前被过滤,凭证引用只返回一个布尔值说明「已配置」。.env 由内置解析器加载,且不覆盖已存在的环境变量,paths.* 里的相对路径统一解析为基于项目根的绝对路径——配置项的含义不依赖进程的工作目录。
两个项目共同的配置原则可以概括成三条:环境变量在加载时展开,业务代码不再直接读取;密钥只进不回,任何接口都不把密钥原样返回;配置是公开接口,作用域、生效值和重启要求要能被人和程序读懂。
一键启动与容器化
对本地优先的单用户系统来说,能不能一键跑起来直接影响使用意愿。CitedRAG 的 setup.sh 幂等:探测 Python 与 Node 版本、建虚拟环境、装依赖、必要时构建前端,重复执行只补缺失步骤;start.sh 用一条 uvicorn 命令启动单进程,FastAPI 直接托管前端产物并做 SPA fallback(单页应用的路由回退),启动后轮询就绪探针、通过后自动打开浏览器;它还接受 backend、frontend、setup 三个子命令,分别对应只起 API、只起开发服务器、只准备环境。想换容器时,Docker Compose 起后端与 Nginx 前端两个容器:后端初始化命名卷后降权运行,健康检查打 /readyz,前端等后端健康后再启动,避免首屏请求打到还没建表的 API。
部署的边界也写得很直白:单进程与容器都只绑定 127.0.0.1,没有认证和 TLS,SQLite 单连接加进程内锁的假设只在本机成立,对外暴露需要另做设计。CI 同样克制——只跑便宜且确定性的检查(固定版本的 ruff 加语法编译、前端类型检查与构建),昂贵的评测留在本地按需复跑。API 演进也保留了兼容层:新能力全部挂在 /api/v1 下,旧端点冻结不动,前端与脚本可以按自己的节奏迁移。
LLM 应用的部署还有两个经常被低估的点:流式接口必须专门照顾中间层,任何一级代理的缓冲都会把「逐字输出」变成「攒一大段再一次性吐出」;就绪探针要和实际依赖对齐,/readyz 只报告本地状态、不触碰模型与外部服务,才能既快又准。
交付形态的选择顺序
CLI、Web 还是 API,这个问题没有普适答案,但有一套可操作的判断顺序:谁在消费结果——终端里的开发者、脚本、浏览器用户还是外部服务;这条通道需不需要双向通信;一次运行中断后,怎么让用户找回它;密钥和敏感数据会经过哪几层;成本是否可见。编程 Agent 天然适合终端优先,交互密度高、离代码近;知识库问答面向阅读与核对,Web 能把证据卡片和原文跳转发挥出来;要被别的系统调用时,API 与结构化事件流就是产品本身。
形态可以换,契约不能含糊:事件流是内核与前端的接口,流式协议是服务端与用户的接口,配置与密钥是系统与运维的接口。先把这些接口定义清楚,再往上叠加形态,比先选一个界面壳子再回头补契约要省事得多。