Project case study
NovaCode · 终端 AI 编程助手
终端里的 AI 编程助手:用自然语言驱动 Agent 读代码、改文件、跑命令,在权限链与 OS 沙箱约束下完成任务。
本文是 NovaCode 作品集案例的总览:从两条设计主线出发,给出总体架构与一次真实调用的端到端链路,模块级深度解析拆分为独立文章,见页面底部的系列文章列表。
一、项目概述
NovaCode 是一个运行在终端里的 AI 编程助手:用自然语言驱动 Agent 读代码、改文件、跑命令,并在权限链与 OS 沙箱的约束下自主完成任务。它不依附任何 IDE,自带 Textual TUI、非交互 Print 模式与浏览器 Remote 模式三种前端,共享同一个 Agent 内核。
- 技术栈:Python 3.11+、asyncio、Textual、Anthropic SDK、OpenAI SDK、MCP、websockets、pydantic、PyYAML。
二、背景与问题
项目有两条主线,整个架构基本都围绕这两个矛盾展开。
矛盾一:自治与安全。 一个能跑 shell 的编程助手,能力上限和破坏上限是同一条曲线。让模型自由执行 rm -rf、写 ~/.bashrc、越权改权限配置,任何一次幻觉都可能造成不可逆损失;但层层弹窗确认又会把「助手」退化成「命令补全器」。NovaCode 的答案是把安全拆成纵深防御:危险命令黑名单在语义层拦截,路径沙箱在文件层约束,三级规则文件给用户可编程的 allow/ask/deny 裁决,权限模式提供整体姿态,最后才是 HITL 确认;配置开启后,Bash 命令还会被包进 bwrap(Linux)或 seatbelt(macOS)做内核级隔离。自动放行的每一步都因此有明确的安全依据。
矛盾二:长会话与上下文。 编程任务是长任务:读文件、搜索结果、跑测试都会往上下文里灌入远超模型窗口的内容。NovaCode 做了两层上下文管理:第一层在工具结果进入历史之前就把大输出溢写到磁盘、只保留预览与回读路径;第二层在接近窗口上限时用 LLM 对早期历史做摘要压缩,压缩边界持久化、支持断点恢复。同时,跨会话的记忆(指令文件、自动记忆、会话记录)承担「上次做到哪」的延续性问题。
围绕这两条主线,其余模块(多 Agent、Skill、Hook、MCP、Worktree)都是扩展面:它们必须共享同一套权限与上下文机制,而不是各自为政。
三、总体架构
flowchart TD
    CLI["入口 __main__.py<br/>TUI / Print / Remote / teammate worker"] --> AGENT["Agent 主循环 run()<br/>异步生成器事件流"]
    AGENT --> CLIENT["LLMClient<br/>anthropic / openai / openai-compat"]
    CLIENT --> AGENT
    AGENT --> STREAM["StreamingExecutor<br/>流式输出期间提交工具"]
    STREAM --> REG["ToolRegistry<br/>24 个内建工具 + MCP + 动态注册"]
    REG --> BUILTIN["文件 / 命令 / 检索 / 交互工具"]
    REG --> MCP["MCP 工具<br/>stdio / Streamable HTTP"]
    REG --> SKILL["Skill<br/>LoadSkill / 斜杠命令"]
    BUILTIN & MCP & SKILL --> PERM{"PermissionChecker.check<br/>五层权限链"}
    PERM -->|allow| EXEC["工具执行<br/>Bash 可包 bwrap / seatbelt"]
    PERM -->|ask| HITL["HITL 确认<br/>TUI 弹窗 / WebSocket 回包"]
    HITL --> EXEC
    PERM -->|deny| REJECT["拒绝结果写回对话"]
    EXEC --> CTX["上下文管理<br/>大结果落盘 + 阈值 LLM 压缩"]
    AGENT --> MEM["记忆<br/>NOVACODE.md / MEMORY.md / JSONL 会话"]
    AGENT --> SUB["SubAgent / Teams<br/>worktree 隔离 + 文件邮箱 + 共享任务板"]
    AGENT -.->|turn_start 等事件| HOOKS["HookEngine<br/>15 类事件 / 4 类动作"]
    HOOKS -.->|pre_tool_use 可拒绝| PERM
四、端到端流程:一次 Bash 工具调用的完整旅程
以「用户要求跑一条命令」为例,真实调用链如下:
- 用户提交消息 → TUI
_send_message写入对话、启动记忆召回预取(8 秒超时)→async for event in self.agent.run(conversation); Agent.run组装 environment / 记忆注入与系统提示词,进入流式请求client.stream;- 模型输出 tool_use 的 JSON 参数过程中,
StreamCollector在content_block_stop后拿到完整的ToolCallComplete,产出ToolUseEvent; - 主循环立即检查权限(
agent.py:589):若是ask,将该调用放入deferred_tool_calls,等流结束后由_execute_tool串行处理(会 yieldPermissionRequest,TUI 弹内联确认框,用户选择回填 future;选「总是允许」则写本地规则);否则调用executor.submit(self._execute_single_tool_direct(tc)),工具在模型还在输出后续内容时已经开始执行; _execute_single_tool_direct(agent.py:835)的执行管线是:查注册表 → 检查启用状态 → 运行pre_tool_useHook(Hook 可以在这里拒绝整次调用)→ 权限检查(deny 直接返回拒绝结果)→ pydantic 校验参数 →tool.execute;- Bash 工具执行时,若挂了沙箱则先把命令包成
bwrap ... -- bash -c <command>(或 seatbelt),再asyncio.create_subprocess_shell执行,stderr 合并进 stdout,默认 120 秒超时;非零退出码附加语义提示返回; - 结果回到主循环:
_maybe_persist_or_truncate判断是否溢写(> 50,000 字符且不是回读溢写文件)→apply_tool_result_budget做整批聚合预算 → 汇总进一条 tool results 消息写入历史; - 主循环继续下一轮:此时历史里已经是终态的工具结果,prompt cache 前缀保持不变;下一轮请求把结果交给模型,模型基于命令输出继续推理或收尾。
以上流程对应的真实运行截图如下(本机实际会话,非示意):流式回答边生成边刷新,工具调用以可折叠块挂在时间线上;权限确认弹窗与 Remote / Print 形态的截图见对应模块文章。
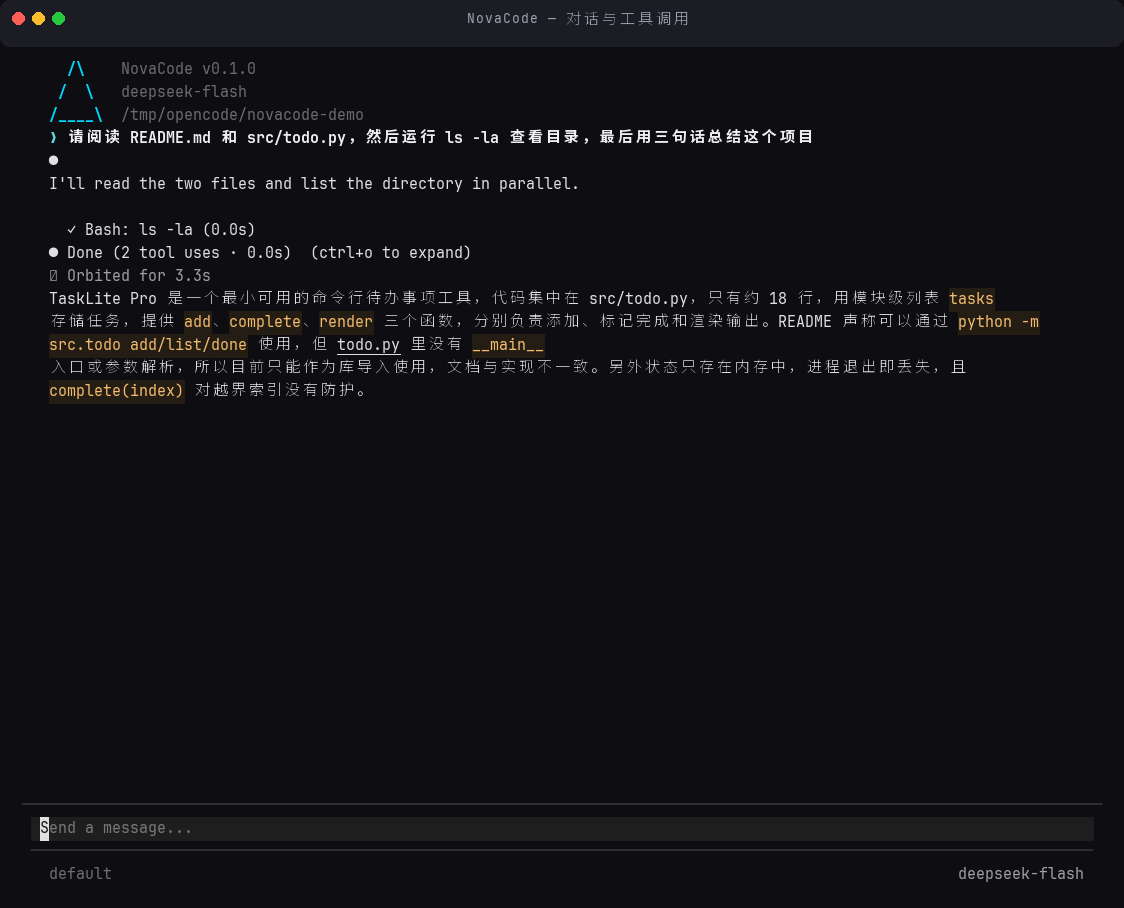
截图之外,Print 与 Remote 两种形态的界面与权限处理在《LLM 应用的交付形态与工程化》中另有截图与说明。
五、结果与数据
当前基线:在仓库根目录执行 uv run pytest -q,实测输出 662 passed, 1 skipped, 1 warning(约 15 秒),uv run pytest -q --collect-only 共收集 663 个用例。唯一跳过的是 tests/test_consolidation.py::test_e2e_consolidation_merges_duplicates——它是全仓库唯一的真实 LLM 调用:设置 NOVACODE_TEST_API_KEY 才运行(可用 NOVACODE_TEST_BASE_URL / NOVACODE_TEST_MODEL 覆盖端点),未设置即 skip,也就是那 1 个 skipped。唯一的 warning 是 PytestUnknownMarkWarning:用例标了 @pytest.mark.timeout(120),但 dev 依赖里没有 pytest-timeout,超时保护实际未生效(已知问题 E1,见《LLM 应用的评测与测试》)。
测试策略的完整说明——默认全 mock、显式异步标记、主目录隔离、手动验证脚本,以及覆盖面与盲区——见《LLM 应用的评测与测试》。
六、工程化
工程约定(依赖与命令走 uv、commit message 用英文 Conventional Commits、不臆造 lint 命令)、六类扩展点(新增工具 / Skill / Hook / MCP 服务器 / 模型协议 / 前端)的改动成本与文档一致性实践,完整记录见《LLM 应用的交付形态与工程化》。
七、踩坑、取舍与已知问题
安全(S1–S7)、Teams / 多 Agent(T1–T6)、运行时健壮性(R1–R6)、测试(E1)与代码健康(C1 / C3 / C4)、底层设计缺陷(D1–D6),以及代码复核新增的发现——完整清单、复现细节与后续修复计划见《LLM 应用的评测与测试》。
八、复盘与路线图
做对的取舍。
- 事件流契约先行:把「模型流」和「工具执行」都收敛成异步生成器事件,让 TUI / Print / Remote 三个前端能在不碰核心循环的前提下各自演化;
StreamEvent归一化则让三种模型协议对上层完全透明。这是整个项目复用率最高的一层设计。 - 缓存稳定性进入架构决策:MCP 加载策略、ToolSearch / mcp_call 的暴露开关、system prompt 只放与项目无关的内容、工具结果进历史前定型——这些选择看似分散,实际都服务于同一条约束:保持 prompt cache 前缀稳定。把「成本模型」写进架构,而不是留给调优。
- 权限判定收敛到唯一入口:
PermissionChecker.check是唯一裁决点,规则文件的 deny > ask > allow 与「规则写在哪一层不影响优先级」让用户的心智模型足够简单。 - 纵深防御承认自身边界:OS 沙箱、规则引擎、危险检测各自覆盖不同层,KNOWN_ISSUES 也明确记录了三者都未覆盖到的入口;不假装「全链一致」。
做错的与代价。
- 同一语义多路径实现(D1,见《两个项目教会我们的事》)是最大的一笔技术债:三条工具执行路径、两套取消、三套错误映射,直接导致 R5 / R6 / S6 这类分叉缺陷;当时的理由是「先跑通再抽象」,但抽象欠下的账在安全路径上会被放大。
- 未完成能力静默成功(D2,见《两个项目教会我们的事》)伤害的是信任:hook 占位实现、
retry_after、死代码分支这类问题的修复成本极低,代价却是使用者对系统能力的错误预期。 - 跨进程协调用文件做最小实现(D4,见《两个项目教会我们的事》)在单机单人场景够用,但 at-most-once 投递、非原子写、无锁任务板意味着它经不起真实并发;正确做法是临时文件 +
os.replace、消息 ack / 幂等键与明确的投递语义。
路线图(按优先级)。
- 统一工具前置管线:把 Hook 检查 + 权限检查 + 结果定型抽成共享管线,三条执行路径只保留调度职责;顺带消灭双重权限检查与
post_tool_use路径差异(D1 / D5 / 代码复核发现,见《两个项目教会我们的事》)。 - 安全修复批次:S1(白名单改子命令 + 参数级、危险检测前移、补
&分隔符)、S2(沙箱可用性进入信任判定)、S6(fork 技能继承权限与 Hook)、S7(计划文件改真实路径判定)、R5(env_context作用域);各问题详情见《两个项目教会我们的事》。 - 跨进程基建:邮箱原子写与投递语义、任务板文件锁、窗格邮箱键统一,并为 pane / remote / sandbox 补集成测试(D4 / T1–T5 / D6,见《多 Agent 协作与隔离》)。
- 显式信任 profile:为每个入口(TUI / Print / Remote / 子 Agent / teammate / Skill fork)定义并展示生效的权限与隔离组合,启动时校验后端可用性(D3,见《Agent 的权限与沙箱》)。
- 能力清单自动化:从注册表与枚举生成工具 / 命令 / Hook 事件清单,消除文档漂移(D6 / D2,见《两个项目教会我们的事》)。
Articles
相关文章
Agent 是怎么跑起来的
从 ReAct 循环到异步事件流,拆解 Agent 运行内核、流式工具执行与多协议模型客户端的归一化。
用 LangGraph 组织 RAG 工作流
从 CitedRAG 的五节点图出发,讲清状态、预算、中断恢复,以及多 Agent 框架的选型逻辑。
上下文工程与长会话
长会话 Agent 的上下文管理:大结果溢写、阈值压缩、三层记忆与 prompt caching 的具体做法与取舍。
Agent 的权限与沙箱
NovaCode 的权限设计:五层权限链、HITL 确认、bwrap 与 seatbelt 沙箱,以及提示注入下的工具权限取舍。
多 Agent 协作与隔离
SubAgent 的独立上下文与 Teams 的跨进程协作:多 Agent 的适用边界、隔离手段与失败模式。