项目概览
IT 服务台每天收到的问题很杂:VPN 连不上、忘记密码、申请权限、装软件、报修硬件、排期变更。OpsDesk 把这些消息自动分类,交给对应领域的 Agent 处理,并在回答前先查知识库、回答后再校验一遍。
项目解决的问题
IT 服务请求常常同时包含症状、业务诉求和紧急程度。例如“发布后 500 报错、网络也不通”既涉及变更,又涉及故障;“收到钓鱼邮件并点开链接”则需要优先升级,而不是继续按普通咨询生成建议。
OpsDesk 将这些判断拆成可观察的步骤:先理解消息,再决定是否检索,再选择主辅处理者,最后判断回答质量和是否转人工。前端是用于查看这条链路的调试台,而不是一个隐藏所有中间决策的聊天窗口。
| 能力 | 输入与输出 | 解决的问题 |
|---|---|---|
| 意图识别 | 消息与近期历史 → 意图、置信度、实体、紧急度 | 从自由文本中提取业务信号 |
| 知识检索 | 业务问题 → 相关片段与排序结果 | 为回答提供组织内的流程依据 |
| 领域编排 | 意图与实体 → 主 Agent、辅助 Agent、路由理由 | 区分单领域和复合问题 |
| 回答校验 | 问题、回答与上下文 → 校验标记和升级建议 | 暴露回答质量判断 |
| 记忆与评测 | 对话及运行结果 → 持久记录与回归比较 | 保留上下文,定位配置或规则退步 |
当前 Agent 提供处理建议和转人工标记,没有实际接入企业账号开通、工单派发或生产发布系统。回复“建议申请权限”与真正授予权限是两个不同的能力范围。
一条消息的旅程
flowchart TD
  A[用户消息] --> B[记忆读取<br/>Redis 近期消息,未命中回源 MySQL]
  B --> C[意图识别<br/>LLM 0.7 + 语义 0.2 + 规则 0.1]
  C --> D{业务意图?}
  D -- 是 --> E[知识检索<br/>改写、并行召回、去重、重排]
  D -- 否 --> F
  E --> F[Agent 路由<br/>领域打分,主辅 Agent]
  F --> G[回答校验<br/>是否解决、是否有依据、是否转人工]
  G --> H[记忆写入]
  H --> I[返回响应]
可观测与评测不在这条请求链上:监控定时采样各 Agent 的成功率和延迟,并把结果回写成惩罚分;评测接口单独跑一批用例,给意图识别和回答质量打分。
为什么采用领域 Agent
三个 Agent 分别聚焦服务台、技术支持、资产与变更,角色提示、匹配规则与补充 Skill 可以分别维护。单领域问题只调用对应处理者;多个领域同时满足条件时并行生成,再合并主辅结果。
这让路由成为可以独立检查的规则:意图识别正确但 Agent 选择错误,与知识召回正确但回答无用,是不同类型的问题。代价是复合请求可能增加模型调用、上下文重复和结果合并成本,不能假设增加 Agent 就一定提高准确率。
值得看的几处设计
- 意图识别不依赖单一来源。 大模型给结构化判断,字符 n-gram 相似度和关键词规则作为另外两路,三路加权投票。大模型不可用时,剩下两路接手。
- 检索只在需要时触发。 闲聊和问候不查知识库,省掉改写、召回和重排的开销。
- 路由有降级和升级。 专属 Agent 失败时退回服务台;紧急度为 CRITICAL,或用户明确要找人时,直接升级并标记转人工。
- 监控回写惩罚分。 成功率低、延迟高的 Agent 实例会被扣分,分数参与同类实例之间的选择。目前每类 Agent 只部署一个实例,所以它暂时只体现在监控数据里。
具体怎么实现的,见意图识别与路由、检索与监控回写和持久化与失败处理。
在演示里试试
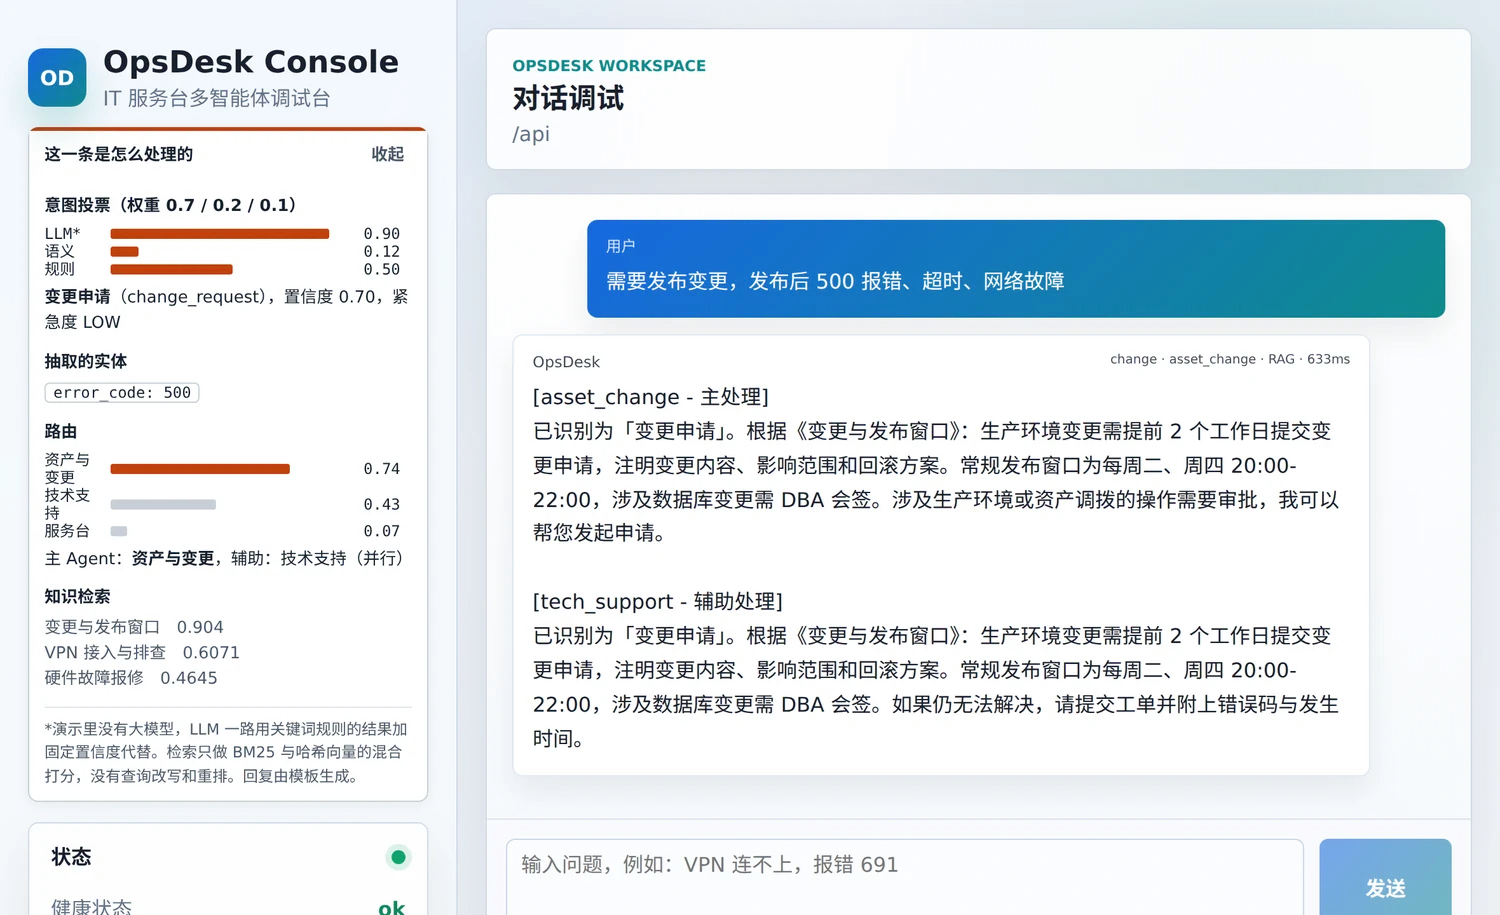
演示里的模拟后端把真实代码里的关键词规则、投票、领域打分、紧急度判断和检索打分用 JavaScript 重写了一遍,所以不同的话会走到不同的 Agent,链路面板会列出这一条的完整处理过程。可以依次发送:
| 发送的话 | 会看到什么 |
|---|---|
| VPN 连不上,报错 691,工单号 #10086 | 识别为 VPN/网络故障,路由到技术支持 Agent,抽取出错误码和工单号,引用《VPN 接入与排查》 |
| 我忘记密码了 | 识别为密码重置,交给服务台 Agent,引用密码重置流程 |
| 收到一封钓鱼邮件,我点了链接 | 安全事件,紧急度 CRITICAL,跳过打分直接升级 |
| 需要发布变更,发布后 500 报错、超时、网络故障 | 变更与技术故障同时命中:资产与变更为主 Agent,技术支持为辅助,并行处理 |
| 你好 | 问候,不触发知识检索 |
| asdf | 置信度太低,系统反问用户要处理哪类问题 |
页面左侧的”运行评测”会用同一套规则跑 20 条内置样例,准确率和 Macro-F1 是现场算出来的。
知识库区域支持手工录入、上传文本资料和独立检索。可以加入一条组织专有的流程,再用包含独有术语的问题查询,观察新增资料如何改变召回。浏览器演示里的新增知识只存在于本次页面生命周期,刷新会回到初始样本。
判断演示结果时,可以同时看实体抽取、三路得分、主辅 Agent、引用片段和升级标记。只看回复是否流畅,会错过规则误判或没有真正命中知识的问题。
演示里哪些是模拟的
- 没有大模型。 意图投票里”LLM”那一路,用关键词规则的结果加固定置信度代替;规则没命中时退回语义相似的结果。
- 检索只做混合打分。 BM25 与哈希向量的融合和后端一致,但没有查询改写和 LLM 重排。
- 回复由模板生成。 内容引用知识库片段,不是大模型写的。
- 评测不含 LLM 评分。 只有意图的准确率和 Macro-F1,结果代表这套规则在这 20 条样例上的表现,不代表线上效果。
- 没有记忆和落库。 刷新页面后会话和新增的知识都会清空。
技术栈
| 层次 | 技术 |
|---|---|
| 后端 | Java 21,Spring Boot 3.5,Spring AI 1.1(Anthropic / DeepSeek),LangChain4j 做文档切分 |
| 数据 | MySQL 8 + Flyway + MyBatis-Plus,Redis 7 |
| 前端 | Vue 3 + Vite,原生 CSS,一个调试台页面 |
| 可观测 | Micrometer + Prometheus,Actuator,Springdoc OpenAPI |
| 测试 | JUnit 5 + H2(MySQL 兼容模式) |
没有配置模型 API Key 时,后端会用确定性的降级回复,整条链路仍然可以跑通。
这种降级适合检查接口、存储与编排连接,不代表模型能力已经得到验证。真实模型接入后的回答质量、延迟和成本,需要使用固定用例重新评估。