架构
沿一次请求解释模块职责、上下文来源、存储分工与评测边界。
模块划分
OpsDesk 的后端是一个 Spring Boot 应用,领域 Agent 是应用内部的不同处理角色,并非分别部署的微服务。模块通过 Java 对象调用完成协作;并行分支使用 CompletableFuture,存储和外部模型调用仍属于同一请求所依赖的资源。
后端按职责拆成十来个包,每个包只负责请求链路上的一段:
| 包 | 职责 |
|---|---|
api | REST 接口与请求/响应对象,/chat 在这里把全链路串起来 |
intent | 三路投票的意图识别,实体抽取(错误码、资产编号、IP、工单号),紧急度判断 |
agent | 服务台、技术支持、资产与变更三个领域 Agent,编排器,回答校验 |
knowledge | 知识库:BM25 与哈希向量融合检索 |
tool | 工具治理:缓存、超时、熔断、降级,包在检索外面 |
memory | Redis 工作记忆,MySQL 全量会话、用户画像、情景摘要 |
evaluation | 端到端评测与历史对比 |
monitor | 指标采样、阈值告警、惩罚分回写 |
skill | 读取 skills/*/SKILL.md,按关键词和 Agent 类型匹配后拼进提示词,有总长度上限,可热加载 |
llm | 对 Spring AI 的封装,含无 Key 时的降级 |
三个领域 Agent
| Agent | 负责 |
|---|---|
| 服务台 | 咨询、权限申请、密码重置、软件安装,也是所有失败的兜底 |
| 技术支持 | 网络与 VPN、登录、硬件、系统故障、安全事件 |
| 资产与变更 | 设备与许可、发布与变更窗口 |
升级路由没有专属 Agent:路由结果记为 ESCALATION,回复仍由服务台 Agent 生成,同时在响应里标记 escalated,提示转人工。
请求入口怎样组织链路
OpsDeskController.chat 先确定用户与会话标识,再读取工作记忆、情景摘要和画像。近期历史的一部分交给意图识别;业务意图触发知识检索,记忆文本和知识片段一起作为领域 Agent 的上下文。
sequenceDiagram
  participant C as 调试台
  participant A as chat 接口
  participant M as MemoryManager
  participant I as IntentRecognizer
  participant K as KnowledgeToolManager
  participant O as AgentOrchestrator
  participant V as AnswerVerifier
  C->>A: 用户、会话与消息
  A->>M: 读取上下文
  A->>I: 识别意图与实体
  opt 业务意图
    A->>K: 改写与检索
  end
  A->>O: 执行主辅领域 Agent
  A->>V: 校验回答与上下文
  A->>M: 写入用户与助手消息,更新画像
  A-->>C: 回答、路由、引用与校验标记
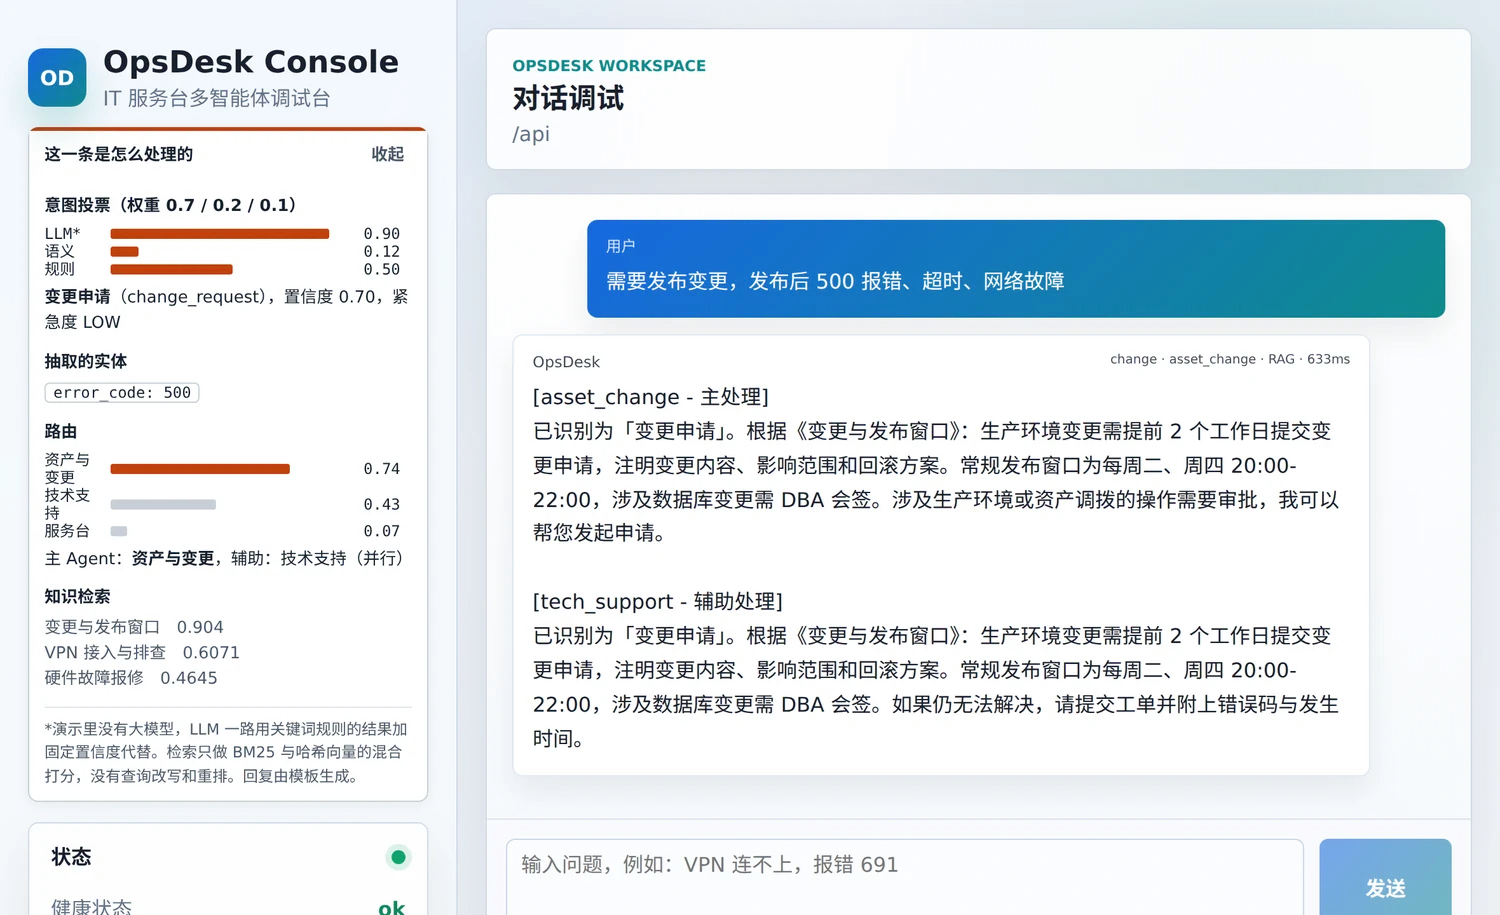
接口返回的不只有回答文本,还包含意图分组、主辅 Agent、路由理由与置信度、实体、知识命中和校验标记。这些字段让调试台能解释同一句话为什么走到某个处理者,而不是让前端根据回答内容猜测后端行为。
源码里的 latencyMs 来自编排结果,不能直接当作整个 HTTP 请求耗时:读取记忆、检索、回答校验和消息写入也会占用时间。查看端到端性能时应结合请求级指标。
三层记忆
flowchart LR
  R[(Redis<br/>工作记忆,有 TTL)] -- 未命中 --> M[(MySQL<br/>完整会话)]
  M -- 回填 --> R
  M --> P[用户画像]
  M --> S[情景摘要]
Redis 里只放最近的对话,超长时压缩;完整会话、用户画像和情景摘要落在 MySQL。近期消息未命中或 Redis 读取失败时回源 MySQL,并尝试回填。这个分支容忍缓存不可用,但数据库异常仍可能影响请求。
三类记忆进入上下文的方式也不同。近期消息保留逐轮内容,情景摘要补充更早对话的相关信息,用户画像记录偏好与常用实体;摘要不是原文备份,画像也不应被当成每轮用户明确确认的事实。
数据表
| 表 | 用途 |
|---|---|
conversation、message | 会话和消息全量持久化 |
user_profile | 大模型提炼的用户画像 |
episodic_memory | 对话压缩后的摘要 |
knowledge_document、knowledge_chunk | 知识文档与切片 |
eval_case、eval_run、eval_result | 评测用例、每次运行的汇总、逐条结果 |
agent_metric | Agent 采样指标 |
表结构由 Flyway 迁移脚本管理。通用增删改查走 MyBatis-Plus,需要 JOIN、聚合和批量插入的查询写在 XML 映射里。
知识、Skill 与记忆的区别
| 来源 | 内容 | 使用方式 |
|---|---|---|
| 知识库 | VPN 排障、权限申请、变更等流程资料 | 按问题检索相关切片 |
| Skill | 某领域的业务处理规则与提示补充 | 按关键词和 Agent 类型匹配后注入 |
| 会话记忆 | 用户之前说过什么、当前问题的上下文 | 按用户和会话读取近期消息 |
| 画像与情景摘要 | 跨轮次提炼的信息 | 补充上下文,减少重复说明 |
Skill 由 SkillManager 加载,匹配后受提示字符预算限制;重新加载会更新可用内容和错误摘要。它不会直接执行一个终端工具,也不能代替知识文档的持久化与检索。
知识库在启动时从数据库加载片段到内存,检索阶段主要访问内存索引。数据库持久化解决重启后恢复,内存结构解决当前进程的查询;多实例间自动同步索引并不是这套结构天然具备的能力。
评测
评测不是一个分数。它分两部分:意图识别的 Accuracy 和 Macro-F1,以及用大模型当裁判,对回答质量打四项分。每次运行的结果落库,并和上一次自动对比,指出哪些用例退步了。
意图评测检查标签是否正确,回答评测关注相关性、准确性、完整性和有用性。两部分可以帮助区分分类退步与生成退步,但当前对话评测直接调用编排器并使用局部历史,不等价于通过 HTTP 跑完知识检索和记忆持久化的所有步骤。完整链路仍需要接口与存储测试补充。